
AIが賢くなるほどメモリが売れる。そう考えて半導体株を見ていたら、今度は「AIの省メモリ化が進んだ」というニュースが流れてくる。持ち株にとって良い話なのか悪い話なのか、迷うところです。
ここで押さえておきたいのがKVキャッシュです。AIが回答を作る途中で使うデータで、モデルの重みとも、スマートフォンの保存容量とも違います。長い資料を読ませる、複数の仕事を同時に頼む。その使い方が変わると、必要な容量も変わります。
容量の計算から、HBM・DRAM・SSDのどこに仕事が増えるのかを考えます。「AI利用が増える」と「メモリ企業の利益が増える」は、間を埋めて確かめます。
資料確認日:2026年10月24日。技術の一般的な仕組みと、明示した仮定による独自計算を扱います。特定企業の売上や株価の予測ではありません。
KVキャッシュとは?AIが過去の文脈を使い直す仕組み
文章を少しずつ生成するTransformer型モデルでは、前のトークンについて計算したKeyとValueを保持し、次の計算で使い直せます。その保存領域がKVキャッシュです。トークンは処理の単位で、文字数と一対一ではありません。基本構造はHugging Face公式の説明で確認できます。
たとえば長い決算資料を読み、その内容について何度も質問する場合。過去の計算を使い直せれば、同じ部分を毎回最初から処理する負担を減らせます。ただし、何を、どれだけ、いつまで保持できるかは実装次第です。
モデルの重み・会話履歴・KVキャッシュは別物
重みは学習で得たモデルの数値、会話履歴は入力や出力の内容、KVはその文脈を処理して得た途中の表現です。利用者の画面に会話が残っていることと、GPU側にKVが残っていることは同じではありません。
重みの容量だけを見て「このGPUなら何人でも使える」とは言えません。推論時にはKVのほか、計算の作業領域なども必要になります。一方、使っていない会話のKVまで永久にすべて残る、と考えるのも過大評価です。
KVキャッシュの容量計算:長い文脈と同時処理が効く
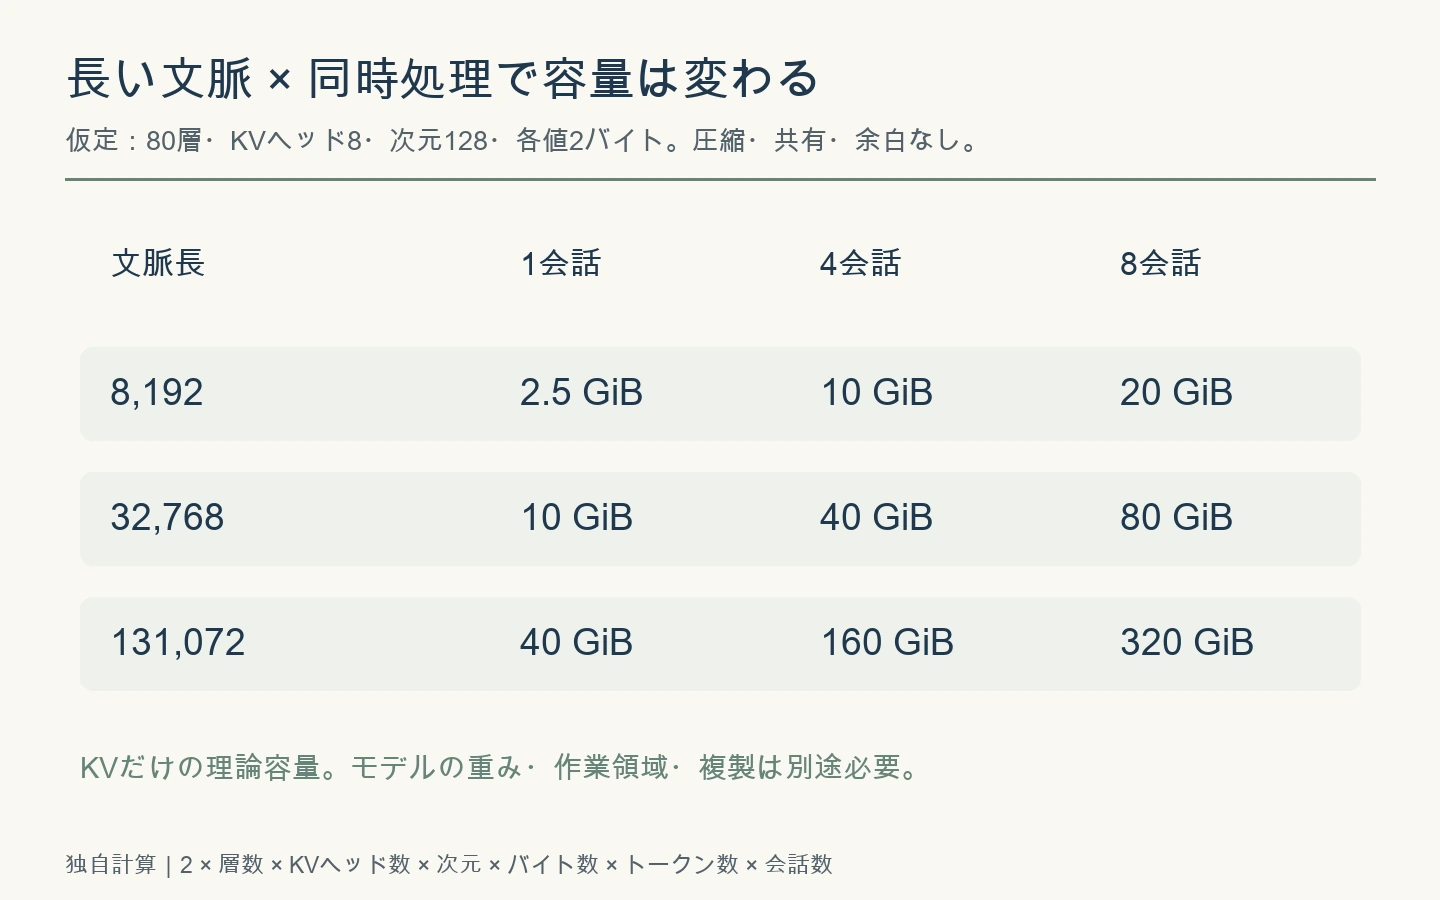
各層で同じ形のKey・Valueを非圧縮で保存する単純な構成なら、次の式で理論容量を見積もれます。実際に確保されるメモリやシステム全体の容量とは区別します。
先頭の2はKeyとValue。各会話の長さが違う場合は、保持トークン数を会話ごとに合計します。
ここでは架空の構成として、80層、KVヘッド8、次元128、各要素2バイトを置きます。1トークン当たりは327,680バイト=320KiBです。131,072トークンを保持する1会話なら40GiB、8会話なら320GiBになります。
「128K」と「128,000」、GBとGiBをそろえる
この図の128Kは131,072です。128,000を入れれば約39.06GiBとなり、同じ値にはなりません。また40GiBは約42.95GB。小さな違いに見えても、多数の会話やサーバーに掛け合わせると差が広がります。
単純な式は、比較の出発点です。GPUを何枚に分けるか、キャッシュの配置、複製、管理用の余白によって実容量は変わります。モデルのパラメーター数だけで上の係数を決めることもできません。実装やモデルの設定にあるKVヘッド数などを確認する必要があります。
GQA・量子化・キャッシュ共有で必要量は減る
GQAはQueryヘッド数ではなく、KVヘッド数を見る
GQAでは複数のQueryヘッドがKey・Valueを共有します。したがって、容量の式へ入れるのはKV側のヘッド数です。Queryが64でもKVが8なら、64を入れるとこの部分を8倍に数えてしまいます。GQAの原論文は、この共有による設計を扱っています。
さらに1要素を表すバイト数を減らす量子化もあります。ただし、重みが4ビットだからKVも4ビットとは限りません。何を量子化しているのかを分けて読みます。品質、処理速度、対応機器との兼ね合いもあります。
MLAやスライディングウィンドウには、単純な式を押し付けない
DeepSeek-V2の原論文にあるMLAは、KVを圧縮した表現で扱う設計です。また、一定範囲だけ保持する注意機構では、入力が長くなっても、全層のKVが同じように伸びるわけではありません。
共通の先頭部分を再利用できる構成では、会話の本数をそのまま掛けると多く見積もることがあります。TensorRT-LLM公式資料にはリクエスト間のブロック再利用の説明があります。ただし、すべての利用者の会話を無条件で共有できるという意味ではありません。内容の一致、保持条件や分離の設計が必要です。
広告
HBM・DRAM・SSD:KVキャッシュはどこに置く?
← 横にスワイプできます →
| 場所 | 期待される役割 | 同時に確かめる制約 |
|---|---|---|
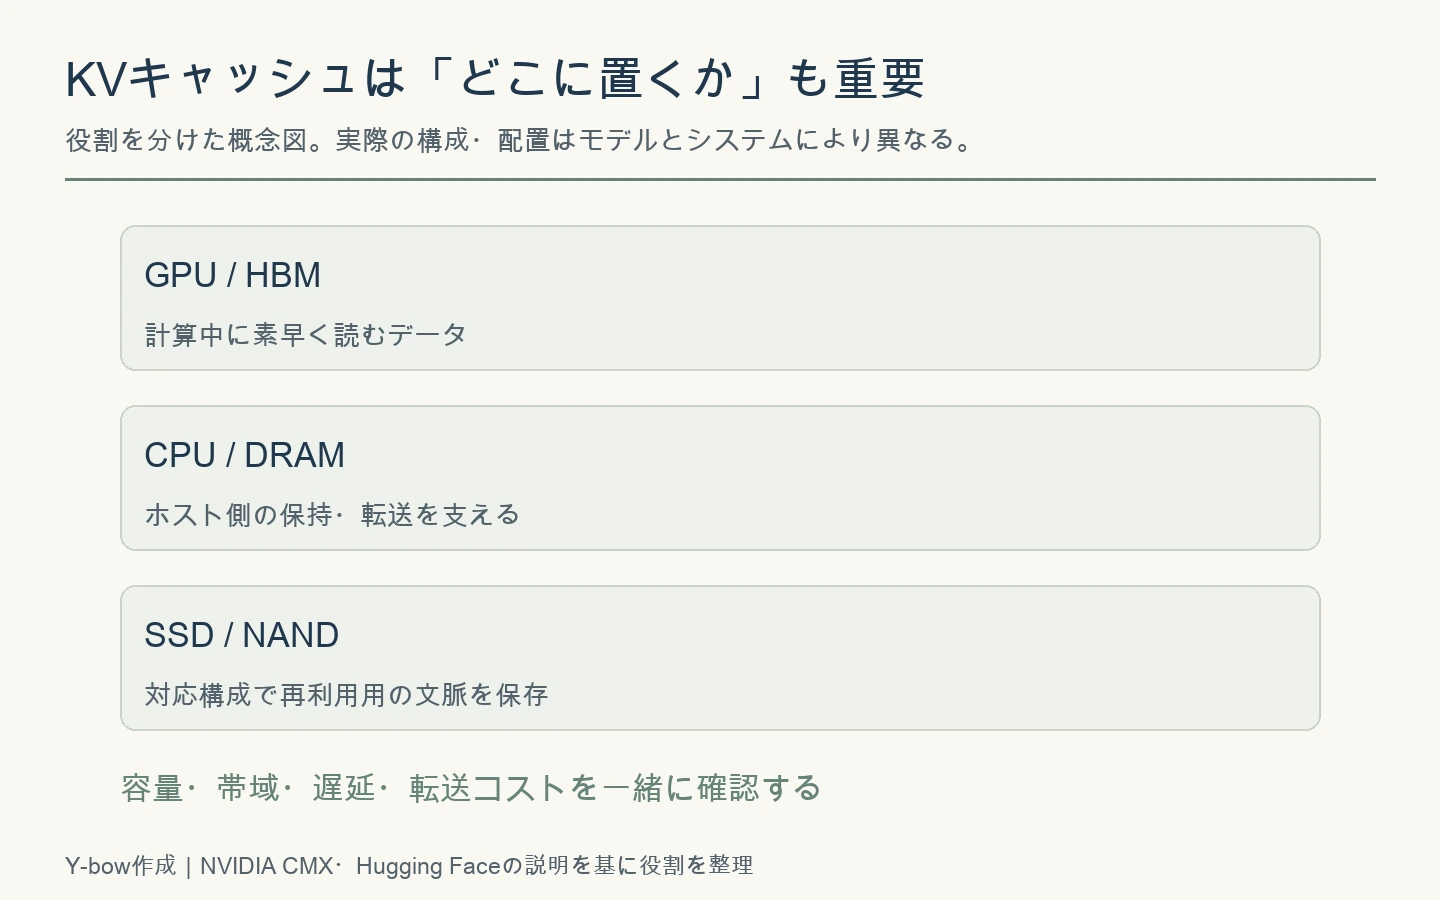
| GPU近傍のHBM | 処理中のデータへ高い帯域でアクセス | 容量だけでなく帯域・実装・電力 |
| ホスト側DRAM | 保持領域、GPUとの転送を支える | 転送時間、CPU・GPU間の接続 |
| SSD(NAND) | 対応する階層構成で文脈を保持・再利用 | アクセス遅延、帯域、耐久性、制御ソフト |
容量の大きな置き場所があっても、必要なタイミングで取り出せなければGPUが待ちます。「保存できる」と「速く使える」は別々に確認します。CPUへのオフロードにも転送との交換条件があり、Hugging Faceのキャッシュ戦略は、対応方式ごとのメモリと速度の違いを説明しています。
NVIDIA CMXが示すのは、HBMの廃止ではなく文脈の階層化
NVIDIA CMXは、BlueField-4を使う共有の文脈メモリ階層を説明しています。GPUのメモリを補い、推論で保持した文脈を使い直す仕組みです。これを「SSDがHBMを全面的に置き換える」と読むのは飛躍です。
同社の技術解説も、計算・ネットワーク・保存側を組み合わせた構成を扱っています。個別の性能倍率は試験条件付きなので、すべてのモデルや既存設備で同じ改善が出る前提にはしません。
キオクシアは2026年6月2日の発表で、KV保存向けのCMシリーズ、別の高IOPS用途を担うGPシリーズ、生成データの保存などを担うLCシリーズを区別しました。用途は一括りにできません。これは当時の製品・戦略の説明であり、そのまま10月の販売実績を示す数字ではありません。
省メモリ化は半導体株に逆風?「単価」と「利用」を分ける
仮に1トークンに必要なKV容量が半分になっても、同時会話数と平均の保持文脈がそれぞれ2倍になれば、合計容量は2倍です。反対に使い方が変わらなければ、必要容量は半分になります。どちらも同じ算数から出てきます。
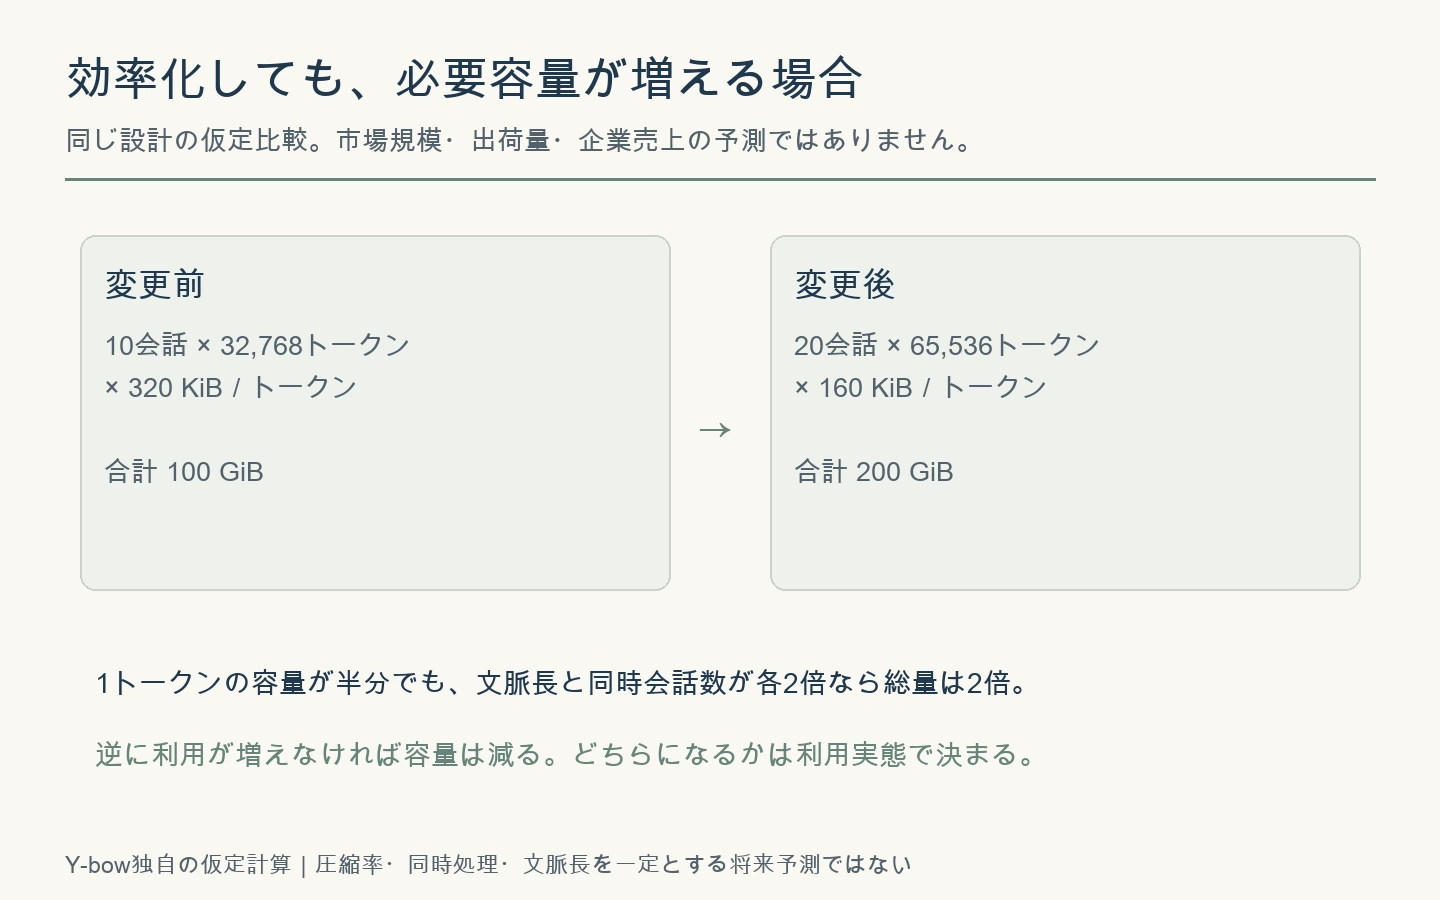
ここで「安くなれば必ず大量に使われる」と決めてしまうと、別の思い込みになります。企業が費用を下げるために同じ仕事量を安く処理する可能性もあれば、長い調査や同時作業へ用途を広げる可能性もあります。
私なら、容量を増やす理由を一つずつ書きます。「文脈が長くなった」「同時処理が増えた」「保持時間が延びた」。そのうえで、共有、圧縮、削除の効果を差し引く。これなら、強気にも弱気にも数字を都合よく使いにくくなります。
メモリ需要を投資判断へつなぐ5つの確認
← 横にスワイプできます →
| 順番 | 確認すること | 避けたい飛躍 |
|---|---|---|
| 1 利用 | 実際の文脈長・同時処理・稼働率 | 利用者数を全員同時接続と扱う |
| 2 構成 | HBM・DRAM・SSDのどこへ置くか | 全容量を特定製品の需要にする |
| 3 採用 | 認定・出荷・顧客導入の段階 | 開発発表を販売済みと扱う |
| 4 売上 | 数量、価格、製品構成、競争 | ビット増加と売上増加を同一視 |
| 5 現金 | 粗利益、研究開発、設備投資、回収 | 高成長だけで株主利益を決める |
「推論でSSDの仕事が増える」は技術と用途の話です。「その会社が利益を残せる」は価格、競争、製造費用、投資負担の話。最後のつながりまで確認して、初めて保有理由を点検できます。
企業ごとの得意分野はメモリ業界の勢力図、需要増が好不況の波をどこまで変えるかはスーパーサイクルに必要な5条件にまとめています。本記事の容量計算を、その確認の出発点にしてください。
動画で帯域を確認する:Why GPUs Need HBM: Memory Bandwidth Explained by Reimu & Marisa。当チャンネルの英語本編です。容量と帯域の違いを図で確認したい方向けです。
KVキャッシュのよくある疑問
KVキャッシュが増えればHBMも同じ割合で増える?
置き場所、圧縮、共有、処理の分割が変わるため、同率とは言えません。容量に余裕があっても帯域が先に制約になる構成もあります。
RAGのデータベースとKVキャッシュは同じ?
同じではありません。RAGは回答に使う外部情報を検索して取り込む仕組みです。取り込んだ内容をモデルが処理すれば、その推論でKVが生じ得ますが、外部の文書保存とKVの保持を二重に同じ需要として数えないようにします。
公開資料だけで将来の総メモリ需要を計算できる?
この式だけではできません。モデル構成、実際の利用、配置、更新周期、単価などが必要です。不明な係数を都合よく埋めるより、どの条件が変われば自分の見方も変わるのかを書いておく方が、決算後の判断に役立ちます。
原典・計算方法・更新方針
技術の原典は本文のHugging Face、GQA・DeepSeek-V2の原論文、NVIDIA CMX・TensorRT-LLM、キオクシア発表です。原典の図表は転載せず、3点の図解と表を当ブログで作成しました。計算は非圧縮・同一形状のK/V、共有なし、指定した同時会話数を仮定。重み、作業領域、予約領域、複製等は除外しています。
企業の製品仕様や出荷状況、実装が変わったときは、その部分の確認日を更新します。技術の採用発表と収益への反映を混ぜず、確かめられる段階に応じて読み直す方針です。
コメント