大規模言語モデルが文章を生成するとき、通常は直前までの出力を見て次のトークンを一つずつ決めます。投機的デコードは、先に複数の候補を作り、本来のモデルがまとめて検証する方法です。候補がよく当たれば検証1回で複数トークンを確定できます。外れが多ければ、候補を作る時間が上乗せされます。
2026年のvLLMやNVIDIA NIMの資料には、別の小型モデルで候補を作る方式や、本体の追加ヘッドを使う方式などが並びます。どのモデル、実行環境、同時処理数で測った結果なのかを確認すれば、公開された高速化の数字を読みやすくなります。
候補生成・検証・採用の順に見る
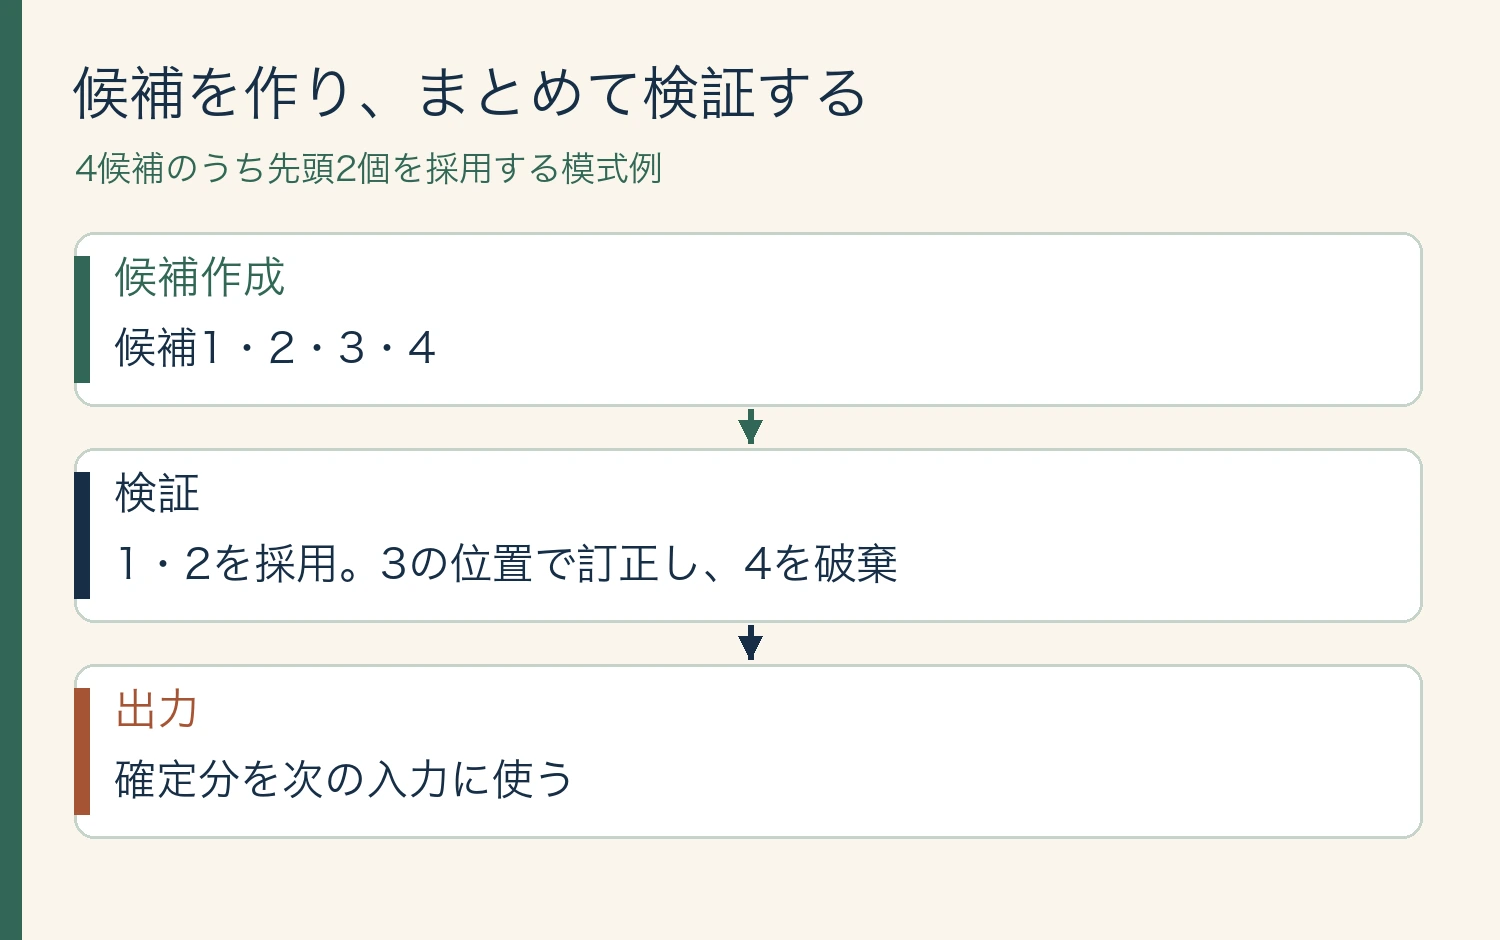
例えば候補側が4個を提案し、本来のモデルの検証で先頭2個まで採用できたとします。以降は不採用箇所で方式に応じた訂正や再サンプリングを行い、その後の候補を使いません。方式によっては全候補が採用された後に追加トークンが確定することもあります。
適切な棄却サンプリングを行う方式では、出力の確率分布を本来のモデルに合わせられます。どの設定でも文字列が完全一致するという意味ではありません。確率的な生成では、同じ分布からの結果でも文字列が異なることがあります。
広告
どのくらい採用されれば速くなる?
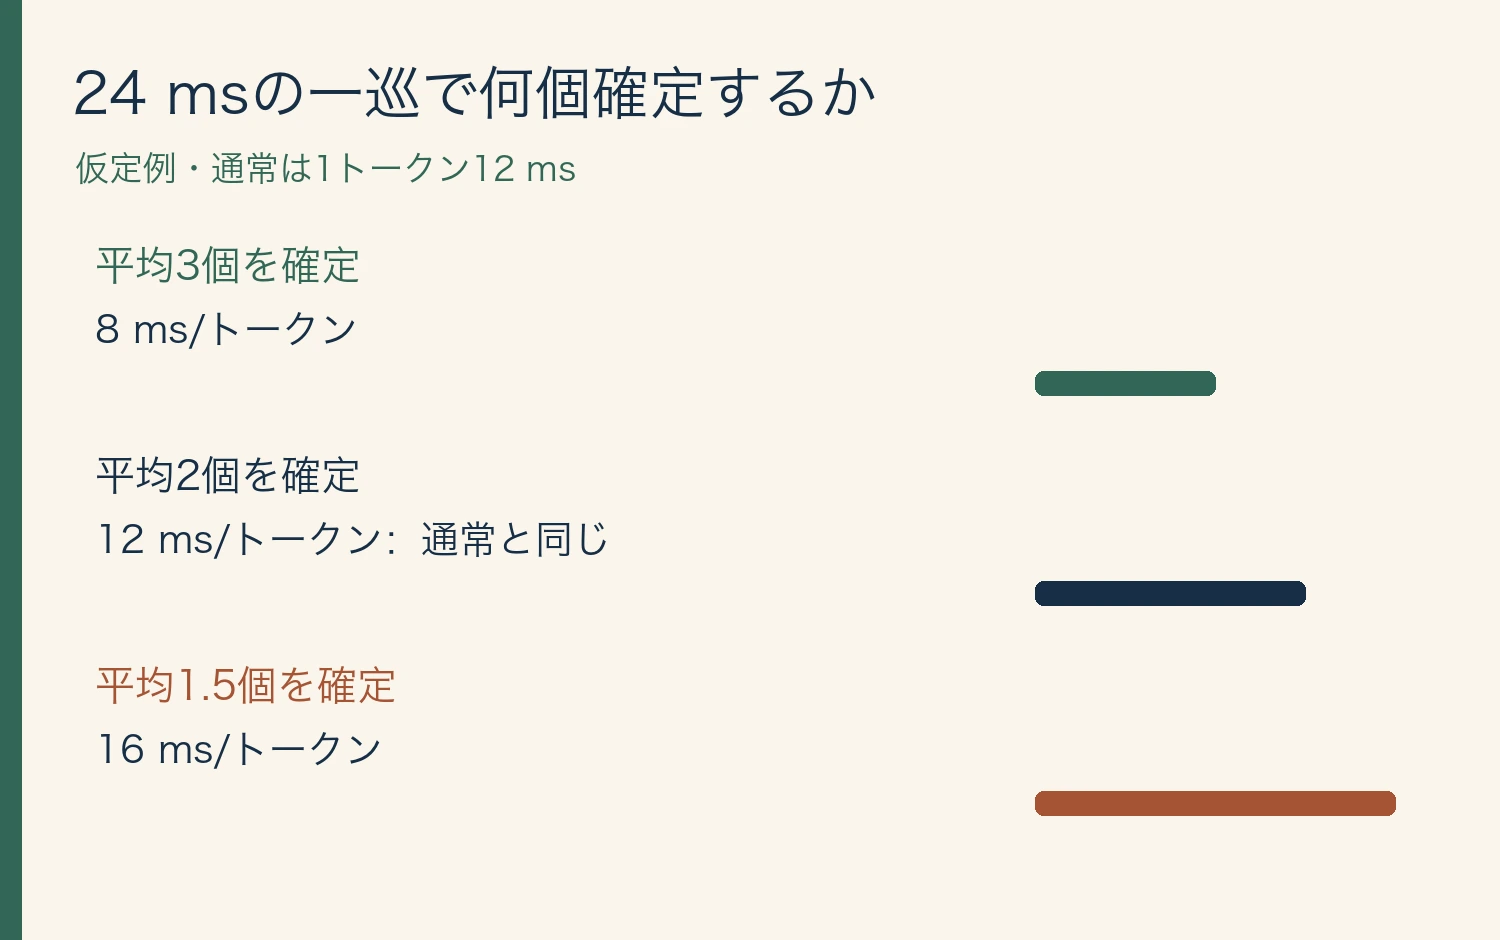
簡単な計算として、通常の生成が1トークン12 ms、候補作成と検証の一巡が合計24 msと仮定します。一巡で平均3トークンを確定できれば1トークン8 ms。1.5トークンなら16 msで通常より遅くなります。ここで数えるのは候補数ではなく、訂正も含めて最終的に確定した出力トークンです。
この例は、一定負荷で端末側の通信や待ち行列を含めない比較です。候補を長くした結果、検証時間も増えることがあります。単に採用率が何%かだけでなく、一巡当たりの確定数と所要時間をそろえて見ます。
最初の応答と生成中の待ち時間を分ける
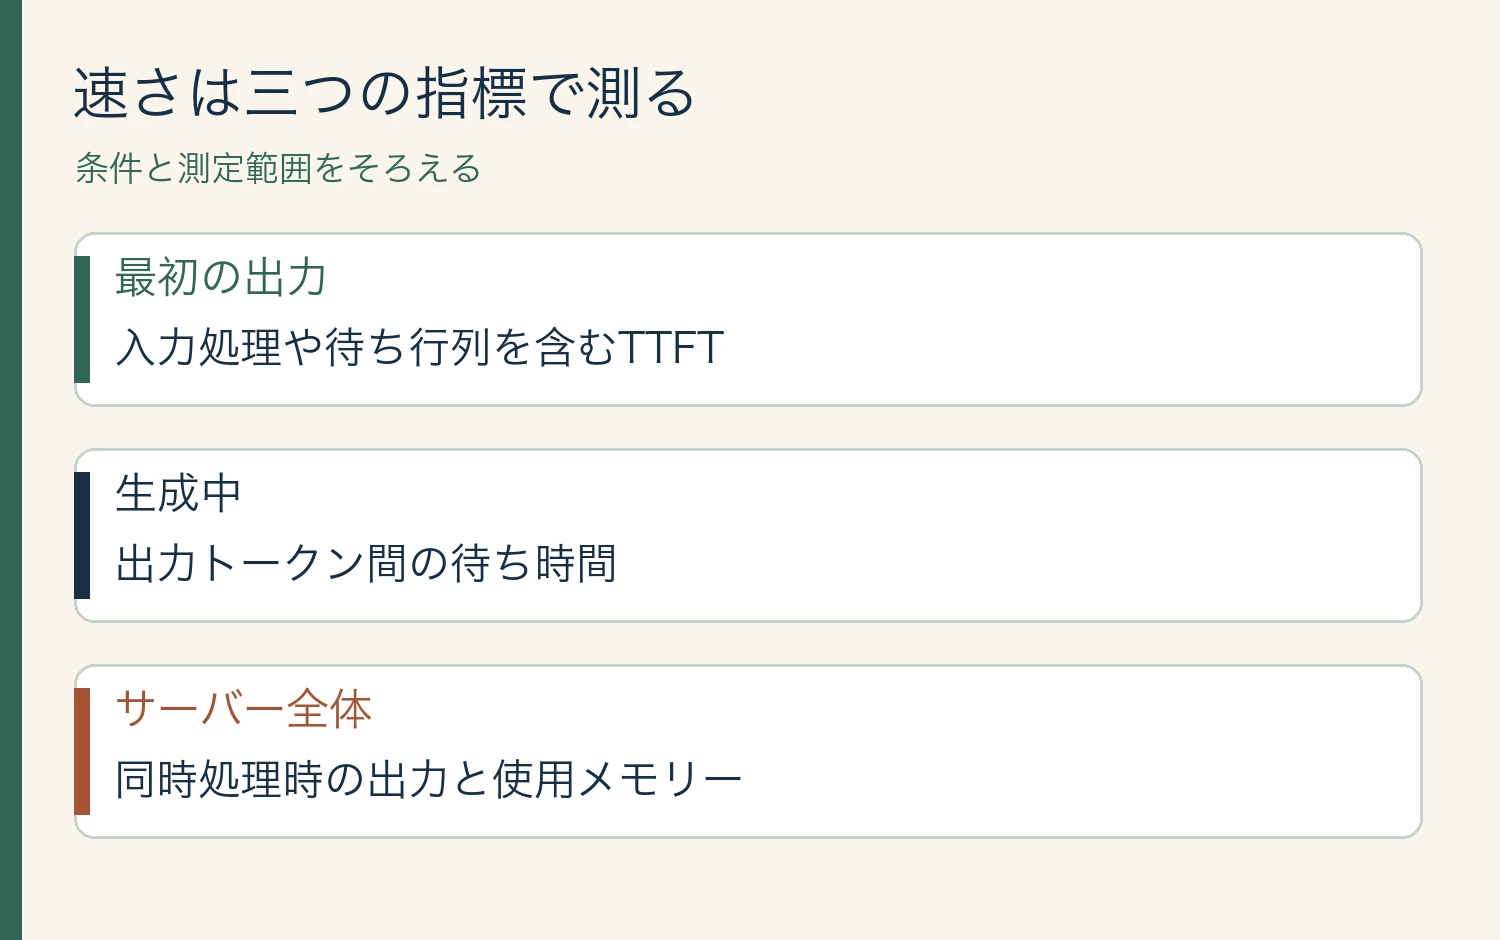
TTFTは最初のトークンが出るまでの時間です。入力処理や待ち行列などの影響を受けます。出力が続く間のトークン間隔や1トークン当たり時間は別に測ります。複数の利用者を同時に扱う環境では、個々の応答が速くてもサーバー全体のスループットやメモリー使用量が同じ割合で改善するとは限りません。
← 横にスワイプできます →
| 項目 | 確認すること |
|---|---|
| 最初の出力 | 入力処理や待ち行列を含むTTFT |
| 生成中 | 出力トークン間の待ち時間 |
| サーバー全体 | 同時処理時の出力と使用メモリー |
広告
ベンチマークの比較条件をそろえる
本来のモデル、候補方式、入力と出力の長さ、同時処理数、測る指標を記録します。候補側に必要な追加メモリーや、サーバーが過負荷になった場合の遅延も確認します。長文生成と短い定型応答で条件を分けると、速くなる用途とそうでない用途の境目が見えます。
よくある質問
投機的デコードとKVキャッシュは同じですか。投機的デコードは候補の検証をまとめる生成方法です。KVキャッシュは過去の計算結果を保持する仕組みです。併用されますが、見るべき効果は異なります。
関連解説:AI推論のKVキャッシュとメモリー
出典と確認日
- vLLMの投機的デコード文書
- NVIDIA NIMの対応と注意点
- Leviathan et al.: Fast Inference from Transformers via Speculative Decoding
資料確認日:2026年11月12日。図表とアイキャッチは当ブログが作成。図中では資料に基づく数値と仮定例を区別しています。
コメント